PIE: Generalizing Perturbation Effects across Unseen Perturbations, Contexts and Datasets
从 Perturb-seq 的实验限制出发,理解 PIE 如何直接预测细胞群体层面的扰动效应,并泛化到未见过的扰动、细胞背景和数据集。
在扰动生物学中,我们希望回答一个看似直接的问题:如果改变细胞中的某个基因,或者给细胞加入一种药物,它的基因表达会怎样变化?
PIE 关注的不只是如何拟合已经做过的实验,而是一个更有挑战性的问题:模型能否把已有实验中学到的规律,推广到未见过的扰动、细胞背景和数据集?
文章目录
- 术语速览
- 从 Perturb-seq 说起
- PIE 的核心想法:直接预测群体层面的扰动效应
- PIE 预测什么?
- PIE 靠什么预测没有做过的实验?
- 读懂 Figure 1:PIE 的模型接口
术语速览
在介绍模型之前,先明确几个会反复出现的概念。
| 术语 | 通俗理解 | 在本文中是什么 |
|---|---|---|
| Gene expression,基因表达 | 某个基因产生多少 RNA | 模型预测的主要读数 |
| Perturbation,扰动 | 主动改变细胞的某个因素 | 基因压低或小分子药物处理 |
| Context,细胞背景 | 在什么样的细胞及状态下做实验 | 某种细胞系,也可以包含细胞因子刺激 |
| Control,对照 | 没有接受目标扰动的细胞 | 用来判断扰动引起了什么变化 |
| Differential expression,差异表达(DE) | 干预组和对照组之间,某个基因的表达存在统计学差异 | PIE 的一个核心预测目标 |
从 Perturb-seq 说起
本文中的遗传扰动主要通过 CRISPRi 实现,核心实验技术是 Perturb-seq。
可以先把 Perturb-seq 理解为:将基因扰动与单细胞 RNA 测序结合起来,从而知道每个细胞接受了什么干预,同时测量它的基因表达。原始数据大致可以表示成下面的矩阵:
| 细胞 | 接受的扰动 | 基因 A 表达 | 基因 B 表达 | 基因 C 表达 | …… |
|---|---|---|---|---|---|
| 细胞 1 | 对照 | … | … | … | … |
| 细胞 2 | 对照 | … | … | … | … |
| 细胞 3 | 压低 A | … | … | … | … |
| 细胞 4 | 压低 A | … | … | … | … |
同一种扰动通常会测量许多个细胞。即使这些细胞来自同一细胞系,它们之间也会存在生物学差异;与此同时,测量过程本身也会引入噪声。
这里有一个决定任务定义的关键限制:常规单细胞 RNA 测序需要破坏细胞,因此无法测量同一个细胞在干预前后的完整转录组。
实验通常得到的是:
一群对照细胞,以及另一群受到干预的细胞。
这意味着我们能够比较两群细胞,却没有每个细胞精确配对的“干预前—干预后”真值。
这正是 PIE 改变任务定义的出发点。
PIE 的核心想法:直接预测群体层面的扰动效应
一些方法会尝试生成“干预后单个细胞的表达状态”,再从生成的细胞中计算差异表达。
PIE 则直接问:
在这个细胞背景下施加这种扰动,哪些基因会改变?往哪个方向改变?改变多少?
因此,PIE 的一个训练样本可以写成:
\[(\text{细胞背景 } c,\ \text{扰动 } p)\]对应的标签,是这一实验条件下每个基因的群体响应。
PIE 的一个重要选择,是让监督目标直接对应实验中能够较可靠计算的群体效应。这样做的代价是:模型不直接生成单细胞层面的异质性。
例如,一个基因可能在一半细胞中升高、在另一半细胞中降低,最终的群体平均值几乎不变。仅依靠群体平均响应,很难完整描述这种情况。
PIE 预测什么?
对于每个输出基因,PIE 同时给出三类结果。
| 输出 | 回答的问题 | 怎么理解 |
|---|---|---|
| DE 概率 | 这个基因会不会发生差异表达? | 一个分类或排序任务 |
| Log fold change(LFC) | 表达升高还是降低?比例变化多大? | 带正负号的变化幅度 |
| Delta expression | 群体平均表达改变了多少? | 干预组与对照组的平均表达差 |
其中,LFC 定义为:
\[\mathrm{LFC} = \log_2 \frac{\text{干预组平均归一化表达}}{\text{对照组平均归一化表达}}\]直观上:
- $\mathrm{LFC}=1$:平均表达变为原来的两倍;
- $\mathrm{LFC}=-1$:平均表达变为原来的一半。
第三个输出 delta expression,是在 log 归一化表达空间中计算的均值之差,与 LFC 并不是同一个量。
在具体实现中,PIE 会把 delta expression 划分成若干区间,预测它属于哪个区间,而不是直接进行连续数值回归。
还需要注意:DE 是一个统计学标签。 本文通过 Wilcoxon 检验及多重检验校正来定义 DE。因此,“是否 DE”不仅受生物学效应影响,还会受到细胞数量、噪声和统计功效的影响。它不能被简单理解为“这个基因是否参与了响应”。
PIE 靠什么预测没有做过的实验?
PIE 主要依赖两类信息。
1. 已有的生物学知识
如果告诉模型“压低基因 A”,模型需要知道 A 是什么,而不能只接收到一个没有含义的编号。
对于遗传扰动,作者使用了以下信息:
| 信息 | 帮助模型知道什么 |
|---|---|
| NCBI Gene 描述和注释 | 基因功能、通路及相关知识 |
| ESM2 蛋白序列表示 | 目标基因编码蛋白的序列特征 |
| STRING 网络表示 | 这个蛋白与哪些蛋白存在关联 |
| DepMap 数据 | 这个基因被敲除后,对不同细胞系生存的影响 |
细胞背景则使用 Cellosaurus 中的细胞系描述。
对于药物扰动,输入包括药物描述、剂量和 SMILES 表示,以及其他实验中的转录、存活和形态响应。
因此,PIE 并不是一个只依靠表达矩阵训练的模型,而是在整合知识库、蛋白表示、网络信息和既有实验。
2. 与每个输出基因有关的实验线索
模型还会参考三种与输出基因有关的证据。假设现在要预测“在细胞 X 中压低 A”的效果:
| 证据 | 模型能够参考什么 |
|---|---|
| 对照平均表达 | 未处理的 X 细胞中,每个基因表达多少? |
| 相同扰动的证据 | 在其他细胞中压低 A 时,哪些基因通常会响应? |
| 相同背景的证据 | 在 X 细胞中施加其他扰动时,哪些基因通常容易响应? |
后两类证据来自训练数据的汇总统计,包括响应的均值、标准差,以及上调、下调的比例。它们并不是待预测条件的实验结果。
因此,PIE 的预测更像是:
综合目标基因的功能、细胞的初始状态,以及相关干预实验的经验,推测这一次扰动可能引起的响应。
读懂 Figure 1:PIE 的模型接口
给定“细胞背景 $c$ + 扰动 $p$”,PIE 会对指定的每个基因 $g$,预测它是否发生差异表达,以及表达变化的方向和幅度。
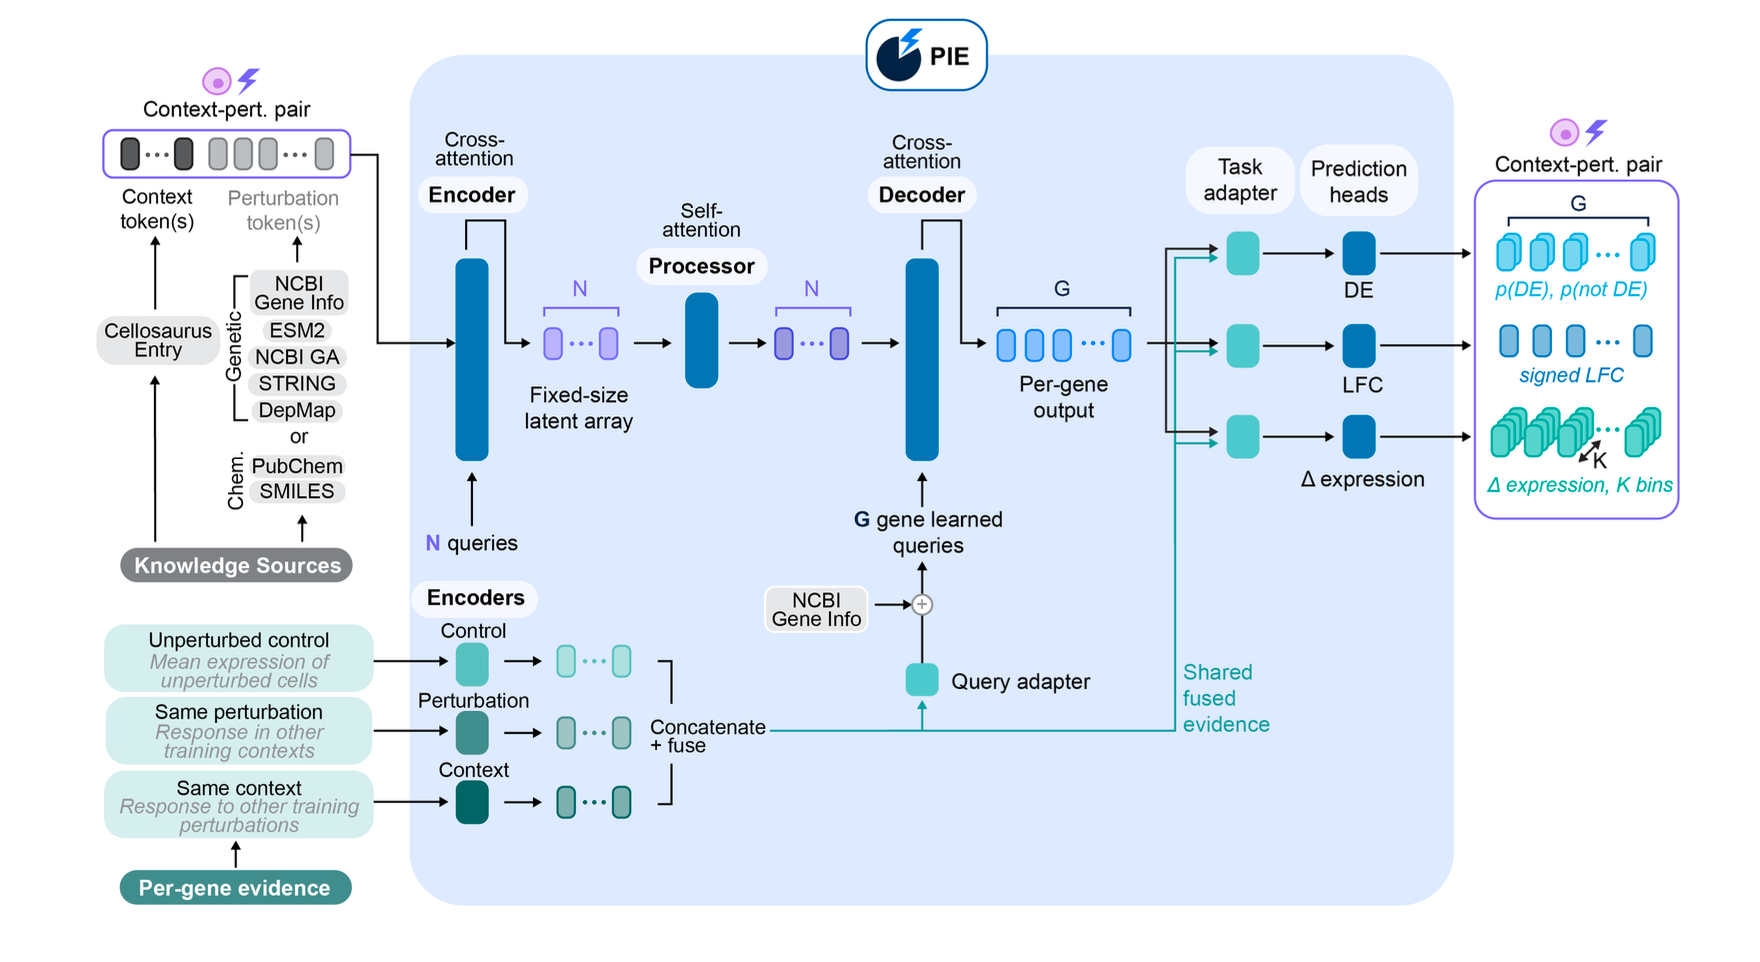
先固定一个例子:我们究竟要求模型做什么?
假设我们要预测:
在 K562 细胞中,用 CRISPRi 压低基因 A,会让其他基因发生什么变化?
这里有三个不同的角色:
| 符号 | 本例 | 含义 |
|---|---|---|
| $c$ | K562 | 在什么细胞背景下做实验 |
| $p$ | CRISPRi 压低 A | 施加什么干预 |
| $g$ | A、B、C、D…… | 要预测哪个基因的响应 |
扰动基因 A 是输入条件的一部分,输出则覆盖成千上万个基因。
假设这次需要预测 $G=6{,}642$ 个基因,那么一次模型调用会返回:
- 6,642 个差异表达概率;
- 6,642 个带正负号的 LFC;
- 6,642 个表达变化量的分箱分布。
一个样本代表一次实验条件,而不是一个细胞,也不是一个基因。 一个样本内部包含成千上万个逐基因预测任务。可以先把它写成:
\[\underbrace{(\text{K562},\ \text{压低 A})}_{\text{一个实验条件}} \longrightarrow \underbrace{\{\text{A 的响应},\text{B 的响应},\ldots\}}_{\text{所有输出基因的响应}}\]不过,“输入一个细胞名称和一个基因名称”只是概念上的说法。真正送入网络的是下面这些数值特征。
1. Knowledge Sources:这是什么实验条件?
先看 Figure 1 左上角的 Knowledge Sources。这条路径回答:
在什么细胞中,对什么对象做干预?
对于“K562 中压低 A”,作者准备了以下资料,再将它们转换成 embedding:
| 来源 | 本例中使用的内容 | 原始表示 |
|---|---|---|
| Context Description | K562 的 Cellosaurus 描述 | 一个 3,072 维文本向量 |
| Perturbation Description | 基因 A 的 NCBI Gene 描述 | 一个 3,072 维文本向量 |
| NCBI Gene Annotations | A 的 GO、疾病关联、基因分组等注释 | 一串 2,048 维文本 token 向量 |
| ESM2 | A 编码蛋白的序列表示 | 对残基表示平均池化后的一个向量 |
| STRING | A 在蛋白关联网络中的表示 | 一个 512 维向量 |
| DepMap | 敲除 A 对不同细胞系存活的影响 | 跨 1,186 个细胞系的数值特征 |
这里有两个细节很重要。
第一,这条路径中的 ESM2 表示针对的是被扰动基因 A 所编码的蛋白,并不是把细胞中所有蛋白的序列都输入 ESM2。
第二,图中的 token 不能一律理解成一个氨基酸或一个基因。这里的 token 是一个可以被 attention 读取的向量:它可以代表整段细胞描述,也可以代表注释文本中的一个 token。
作者把各来源的向量分别映射到统一的 768 维,加上表示数据来源的类型向量,再将它们拼接起来:
\[X_{c,p}\in\mathbb{R}^{M\times768}\]其中,$M$ 是这个实验条件拥有的知识 token 总数。不同基因的资料长度和数据库覆盖率不同,因此 $M$ 可以变化。如果某个数据库没有基因 A 的资料,就省略该来源对应的 token。
到这里,左上角已经准备好了一组“关于 K562 和 A 的知识向量”。
2. Per-gene Evidence:每个输出基因已有何种实验证据?
再看 Figure 1 左下角的 Per-gene evidence。它回答的不是“A 是什么”,而是:
对于要预测的基因 B,手里已经有哪些关于 B 表达行为的线索?
注意,我们现在从被扰动的 A,切换到了输出基因 B。每一个输出基因都有自己的三类证据:
| 证据通道 | 对输出基因 B 来说,具体是什么 |
|---|---|
| Control Mean Evidence | 未处理 K562 细胞中,B 的平均表达 |
| Same-pert Evidence | 在其他细胞背景中压低 A 时,B 通常怎样变化 |
| Same-context Evidence | 在 K562 中进行其他扰动时,B 通常怎样变化 |
最容易混淆的是后两项:
Same-pert:干预对象不变,换细胞背景。
Same-context:细胞背景不变,换干预对象。
例如,在预测“K562 中压低 A”时:
- 已知“在 HepG2 中压低 A,B 会怎样变化”,属于 Same-pert;
- 已知“在 K562 中压低 C,B 会怎样变化”,属于 Same-context;
- “在 K562 中压低 A,B 的真实变化”是本次预测目标,不能作为证据输入。
两个响应通道并不输入所有原始细胞,而是输入训练响应的汇总统计,包括:
- B 的表达变化量的均值和标准差;
- B 的 LFC 的均值和标准差;
- B 被判为上调或下调的比例;
- 是否存在可用证据,以及贡献了多少个响应等辅助信息。
随后,各统计模块分别进行编码和拼接,再通过 fusion MLP,得到:
\[e_{c,p,B}\in\mathbb{R}^{128}\]对所有输出基因重复这个过程:
\[E_{c,p}\in\mathbb{R}^{G\times128}\]因此,左下角并不是一个全局的“细胞表达向量”,而是为每个输出基因准备的一份实验证据。同一个输出基因 B,在不同的待预测条件下,其证据向量也会发生变化。
3. NCBI Gene Info:现在要预测谁?
此时我们已经有了:
- 左上角:这次实验是什么;
- 左下角:每个输出基因已有的实验证据。
还缺一个问题:
模型怎样知道当前要输出的是 B,而不是 C?
作者为每个输出基因也准备了 NCBI Gene 描述的文本 embedding。以 B 为例:
\[t_B\in\mathbb{R}^{3072}\]它先经过 query MLP,被映射到 768 维;随后,B 的 128 维证据向量经过 query adapter 映射到相同维度。二者相加并归一化:
\[q_{c,p,B}=\operatorname{Norm}\!\left[ \operatorname{MLP}_{\mathrm{gene}}(t_B) +\operatorname{Adapter}_{\mathrm{evidence}}(e_{c,p,B}) \right]\]最终得到:
\[q_{c,p,B}\in\mathbb{R}^{768}\]这就是 gene query。可以把它理解成一个带有背景的问题:
“我是基因 B,已有这些实验证据。请告诉我,在 K562 中压低 A 后,我会怎样变化?”
所有输出基因的问题合在一起:
\[Q_{c,p}\in\mathbb{R}^{G\times768}\]这也解释了 Figure 1 中两个看起来相似、实际角色不同的 NCBI 输入:
| 位置 | 描述谁 | 作用 |
|---|---|---|
| 左上角 NCBI Gene Info | 被扰动的基因 A | 说明“干预对象是谁” |
| 下方 NCBI Gene Info | 每个输出基因 B、C、D…… | 说明“现在预测谁” |
即使输出基因恰好也是 A,它在两条路径中仍然承担不同的角色,并使用不同的投影模块。
4. Encoder–Processor–Decoder:模型在传递什么?
现在再看图中间的蓝色大框。
Encoder:让固定数量的 latent 读取实验知识
模型首先维护一组可学习的初始向量:
\[Z_0\in\mathbb{R}^{512\times768}\]这 512 个 latent 是模型参数,并不是 512 个细胞、512 个基因或 512 条实验。它们通过 cross-attention 读取左上角的知识 token:
\[Z_{\mathrm{enc}}=\operatorname{Encoder}(Z_0,X_{c,p})\]| Attention 中的角色 | 来自哪里 |
|---|---|
| Query | 512 个 latent |
| Key、Value | 细胞背景与扰动的知识 token |
无论知识输入包含多少个 token,读取后始终得到:
\[Z_{\mathrm{enc}}\in\mathbb{R}^{512\times768}\]Processor:让 latent 彼此交流
Processor 使用 latent 之间的 self-attention:
\[Z_{\mathrm{proc}}=\operatorname{Processor}(Z_{\mathrm{enc}})\]张量形状仍然保持为:
\[Z_{\mathrm{proc}}\in\mathbb{R}^{512\times768}\]可以把它理解成模型整合后的“本次实验条件表示”。
Decoder:让每个输出基因读取条件表示
这一次,cross-attention 的方向发生了变化:
| Attention 中的角色 | 来自哪里 |
|---|---|
| Query | 每个基因的 gene query |
| Key、Value | Processor 输出的 latent |
于是:
\[H_{c,p}=\operatorname{Decoder}(Q_{c,p},Z_{\mathrm{proc}}) \in\mathbb{R}^{G\times768}\]其中第 B 行:
\[h_{c,p,B}\in\mathbb{R}^{768}\]表示“结合本次细胞背景、扰动知识和 B 的实验证据后,得到的 B 的响应特征”。
这里有一个关键的结构细节:输出基因的 query 之间没有直接的 self-attention。 B、C、D 都会读取共享的 latent,但在解码时不会彼此直接交换信息。
因此,这套结构并没有显式构建一个“B 调控 C、C 再调控 D”的动态模拟过程。
5. 三个 Prediction Heads:把逐基因特征变成答案
对于输出基因 B,decoder 会生成一个 768 维特征。进入每个预测头之前,作者还会通过 task adapter,再融合一次 B 的证据向量:
\[\widetilde h_B^{(t)}=h_B+\operatorname{MLP}_t([h_B,e_B])\]其中,$t$ 代表不同任务,每个任务拥有自己的 adapter。因此,Figure 1 中的 evidence 有两处用途:
- 在 decoder 之前,帮助构造 gene query;
- 在预测头之前,帮助不同任务使用实验证据。
随后,模型产生三个输出:
| 预测头 | 每个基因的直接输出 | 后续如何使用 |
|---|---|---|
| DE head | 两个 logits | 通过 softmax 得到 DE / 非 DE 概率 |
| LFC head | 一个实数 | 正负分别表示上调或下调 |
| $\Delta$-expression head | $K$ 个 logits | 通过 softmax 得到变化量分箱的概率分布 |
对于一个包含 $G$ 个输出基因的实验条件,直接输出的张量形状为:
\[\begin{aligned} \text{DE logits}&:\quad G\times2\\ \text{LFC}&:\quad G\times1\\ \text{Delta logits}&:\quad G\times K \end{aligned}\]这里的 $K$ 是表达变化量的分箱数量,并不是细胞数量。在主基准的不同训练折中,作者使用了 13 或 17 个 bin。
最终结果可以整理成下面的形式。表中数值仅作示例,并非论文结果:
| 输出基因 | DE 概率 | 预测 LFC | 预测 $\Delta$-expression |
|---|---|---|---|
| A | 0.98 | −1.6 | −0.7 |
| B | 0.85 | +0.8 | +0.3 |
| C | 0.09 | −0.1 | 0.0 |
| D | 0.72 | −0.6 | −0.2 |
这张表描述的是 K562 中压低 A 后,细胞群体的响应。模型并没有在这里生成一批单细胞表达矩阵。
6. 三个训练标签怎样得到?
训练时,“K562 中压低 A”这个条件已经真正做过实验。作者拥有:
- 一群未处理的 K562 对照细胞;
- 一群受到 A 扰动的 K562 细胞。
随后,作者针对每个输出基因 B 计算三个标签:
| 任务 | 真值怎样得到 | 训练范围 |
|---|---|---|
| 是否 DE | 两群细胞进行 Wilcoxon 检验,BH 校正后 FDR < 0.05 | 通过表达过滤的基因 |
| LFC | 干预组与对照组平均归一化表达的 $\log_2$ 比值 | 真值中的 DE 基因 |
| $\Delta$-expression | 干预组平均 log 归一化表达 − 对照组平均 log 归一化表达 | 所有具有有效 $\Delta$ 的测量基因 |
相应的训练目标包括:
- DE 分类损失;
- LFC 数值的 Huber 损失;
- LFC 正负方向的损失;
- $\Delta$-expression 分箱分布的交叉熵损失。
必须把标签和证据分开理解:
目标条件的真实响应,用来监督模型。
其他训练条件的响应汇总,可以作为证据输入。
模型并不是把本次实验的答案放入输入,再学习输出同一个答案。
7. 换成“新细胞”或“新扰动”时,少了什么?
模型结构不会改变,主要变化在于哪些证据可用:
| 测试情况 | 对照均值 | Same-pert 证据 | Same-context 证据 |
|---|---|---|---|
| 新细胞,已见扰动 | 有 | 有相关训练响应时可用 | 无 |
| 已见细胞,新扰动 | 有 | 无 | 有相关训练响应时可用 |
| 新细胞,新扰动 | 有 | 无 | 无 |
知识库资料仍然会按照数据库的实际覆盖情况提供。
因此,“新细胞 + 新扰动”并不意味着模型只输入两个名称。 它仍然可以获得:
- 细胞背景的描述;
- 扰动对象的各种知识特征;
- 每个输出基因的描述;
- 新细胞背景中,每个基因的未扰动对照均值。
缺失的响应证据会被置空,并通过 presence flag 等机制标记。训练时,作者也会随机屏蔽响应证据,使模型适应证据缺失的情况。
把 Figure 1 压缩成一份模型接口
| 模型所需内容 | 数值形式 | 在图中的位置 |
|---|---|---|
| 细胞背景和扰动的知识 | $M\times768$ 个知识 token | 左上角 → Encoder |
| 每个输出基因的描述 | 每个基因一个文本向量,再映射到 768 维 | 下方 → gene queries |
| 每个输出基因的实验证据 | $G\times128$ | 左下角 → query adapter 和 task adapters |
| 返回结果 | DE:$G\times2$;LFC:$G\times1$;$\Delta$:$G\times K$ | 最右侧三个 heads |
读 Figure 1 时,只需要抓住两条路径:左上角告诉模型“这是什么实验”;左下角和下方告诉模型“现在预测哪个基因,以及它有哪些已有证据”。 中间的 Encoder–Processor–Decoder 将两者结合,最右侧再逐基因输出答案。